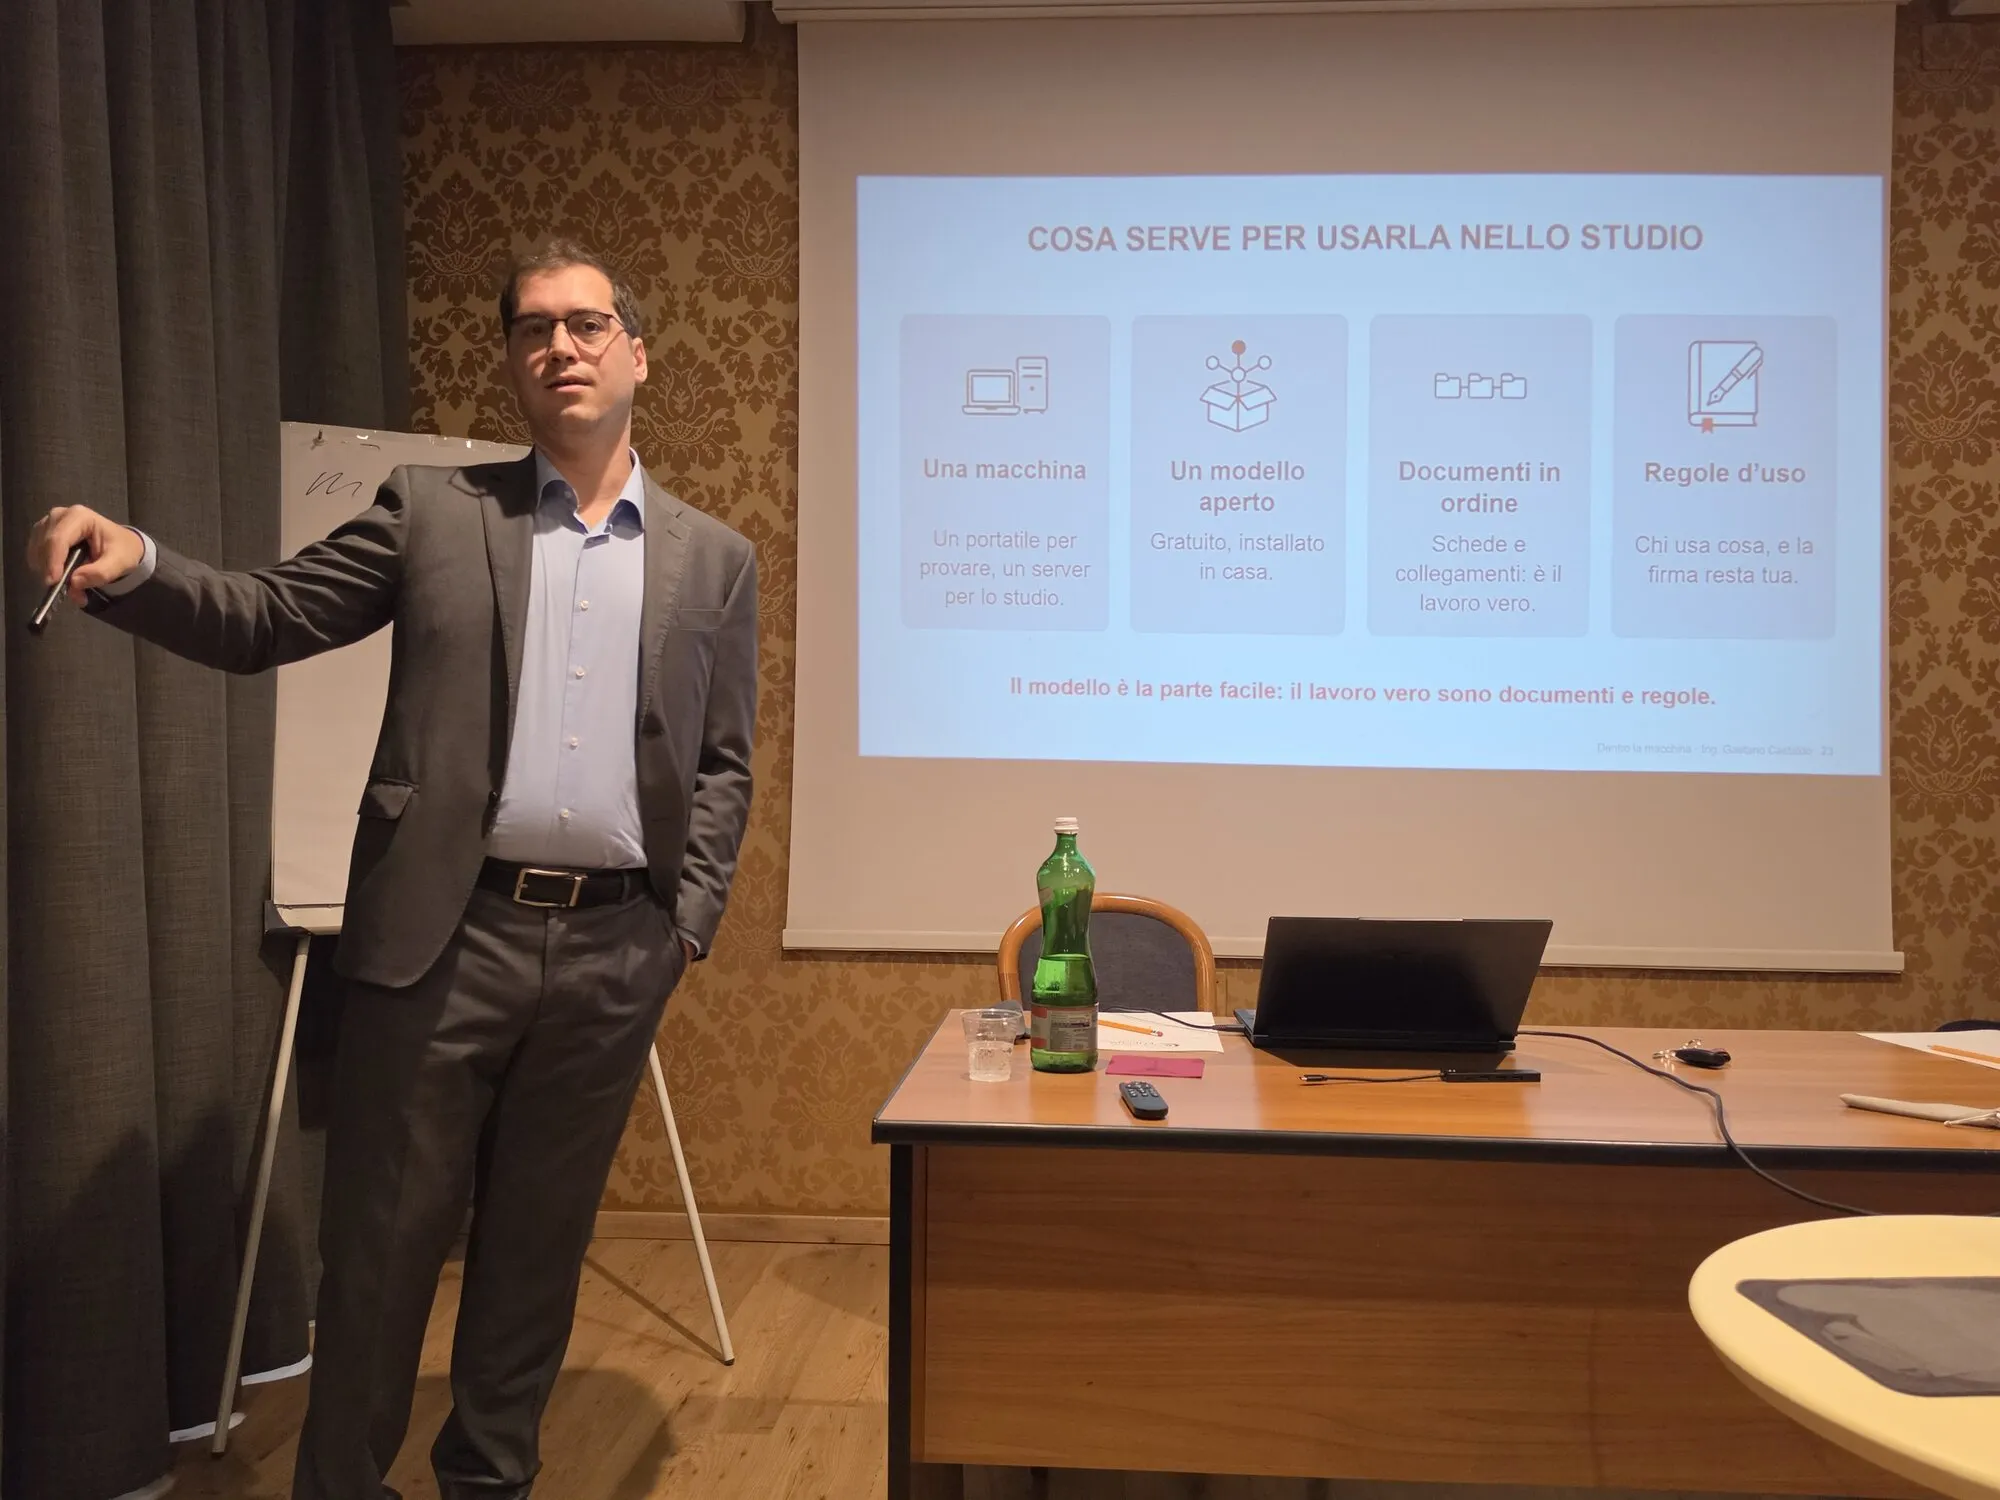
Perché un ingegnere in un laboratorio per avvocati?
Perché dal 23 ottobre 2026 la formazione organizzata dagli Ordini professionali deve includere l’intelligenza artificiale su tre profili: tecnico, giuridico e deontologico. Lo dice l’art. 47 del d.lgs. 179/2026. Il primo profilo è il mio mestiere: spiegare come funziona la macchina a chi poi ne risponde.
Con Armando ci dividiamo il lavoro come nel nostro podcast, Innovazione Sotto Processo: io racconto come si costruisce un sistema e dove si rompe, lui chi ne risponde e come ci si tutela. Per gli eventi istituzionali gli accordi erano chiari dall’inizio: slide neutre, senza loghi, niente di commerciale. In sala si parla della macchina, non di chi la vende.
Come si prepara una demo di AI che non può contare su internet?
Mi sono dato una regola sola: quello che la sala vede deve girare sul portatile che ho davanti, senza rete. Altrimenti «i dati non escono» resta una promessa, non una prova.
Il portatile ha una scheda grafica da 8 GB, e preparare il laboratorio è stato un esercizio di budget. Il modello, Qwen3.5 9B compresso a 4 bit, occupa 5,2 GB; la conversazione, fino a circa 16.000 pezzi di parola, mezzo giga. Misurato l’8 novembre con una sola chat aperta: 7.284 MB occupati, 673 liberi. Con il doppio di conversazione non ci stava più. Per questo l’archivio intero non entra nel modello: il modello lo deve cercare, ed è proprio quello che volevo far vedere.
Le cose che si rompono le ho trovate prima, e sono sempre le stesse:
- La scheda tiene un modello alla volta. Le prime prove giravano con Ollama, l’archivio con LM Studio: in mezzo, uno script libera la memoria e ricarica il modello in una quindicina di secondi, il tempo di mostrare le note.
- LM Studio, aperto dal terminale dell’editor, si chiudeva appena partito per una variabile d’ambiente ereditata. Dal menu Start no. Si scopre solo provando sulla macchina vera.
- Dopo cinque o sei domande la conversazione si riempie, e si apre una chat nuova.
E per ogni passaggio dal vivo c’era un piano B: le schermate vere delle prove, già nelle slide. Una demo che non può fallire non esiste. Una che sopravvive al proprio fallimento sì.
Perché l’archivio di note l’abbiamo costruito su Armando?
Perché in una demo pubblica i dati dei clienti non ci vanno, e un archivio finto non convince nessuno. Armando si è offerto lui: in sala poteva confermare o correggere ogni risposta.
L’archivio sono 64 note in Obsidian, scritte solo da pagine pubbliche lette l’8 novembre 2026: il suo sito, quello dello studio, il podcast, le notizie dei suoi interventi. Niente social, niente contatti, niente vita privata. Ogni nota dice da quale pagina viene, e uno script controlla che le 124 frasi tra virgolette e i 214 numeri delle note si ritrovino davvero in quelle pagine. Oggi tornano tutti.
Le domande più utili, nelle prove, sono state quelle a cui l’archivio non sa rispondere. Una l’ha proposta Armando: se fosse iscritto negli elenchi del gratuito patrocinio. Non lo è, nessuna pagina ne parla, e il modello ha risposto che nell’archivio non c’è. Ha anche sbagliato: ha scritto che Armando aveva promosso un evento in cui era solo annunciato come relatore. Siccome cita la nota da cui prende ogni frase, l’errore si vede subito.
Prima di cercare, il modello chiede il permesso di usare lo strumento che legge l’archivio, e qualcuno deve cliccare. Non ho mai spuntato «consenti sempre»: il permesso doveva vedersi ogni volta, perché è la firma dell’avvocato in piccolo. In sala, alla domanda su cosa intende Armando per «human in command», la risposta è arrivata con le note citate una per una.
Cosa mi porto a casa?
Armando ha raccontato che la domanda che gli fanno più spesso è quale sia l’AI migliore. In sala l’ha ribaltata: «la domanda decisiva non è quale IA usare, ma è dove farla girare». È quello che avevo detto io parlando di modelli aperti e chiusi, dove gira il modello e chi vede i dati, detto con le parole di chi poi ne risponde. Per me è il segno che la divisione del lavoro fra tecnica e diritto funziona.
E ho tenuto la storia di Geoffrey Hinton, perché a un avvocato serve: uno dei padri di queste reti, intervistato da 60 Minutes nel 2023, ha detto che non capiamo davvero come facciano quello che fanno. Se non lo sa fino in fondo lui, ogni risposta va verificata. Non è sfiducia nella macchina: è il metodo di chi lavora sulle fonti.
La parte per chi guida uno studio, con le tre strade per i dati, gli obblighi di legge e cosa serve per cominciare, l’ho scritta sul sito di Castaldo Solutions. Questa pagina resta il retro del palco.